01 85 09 08 00 · 24 h/24
ChatGPT · Gemini · Perplexity · Aperçus IA de Google
Réponse des IA : ce qu’elles disent quand on demande qui vous êtes.
Un moteur affichait des liens et laissait le lecteur arbitrer. Une IA produit une réponse unique, affirmative, sans contradiction visible — et elle la construit à partir d’un petit nombre de sources qu’elle juge fiables. Ces sources sont connues, mesurées, et ce ne sont pas celles que vous croyez. Nous les travaillons.
Ce que quatre IA répondent aujourd’hui sur votre nom, et les sources qu’elles citent réellement.
La réponse de référence : ce qu’une IA devrait dire, exact et défendable.
Les sources fausses ou périmées, à la source et non dans l’affichage.
Ce qui manque : la source qui n’existe pas encore et que l’IA citera.
Chaque mois, l’écart entre la réponse obtenue et la réponse de référence.
Le malentendu
Aucun formulaire ne corrige une IA
C’est la première chose à comprendre, et celle qui écarte la plupart des propositions que vous entendrez : il n’existe pas de procédure de rectification auprès d’une IA.
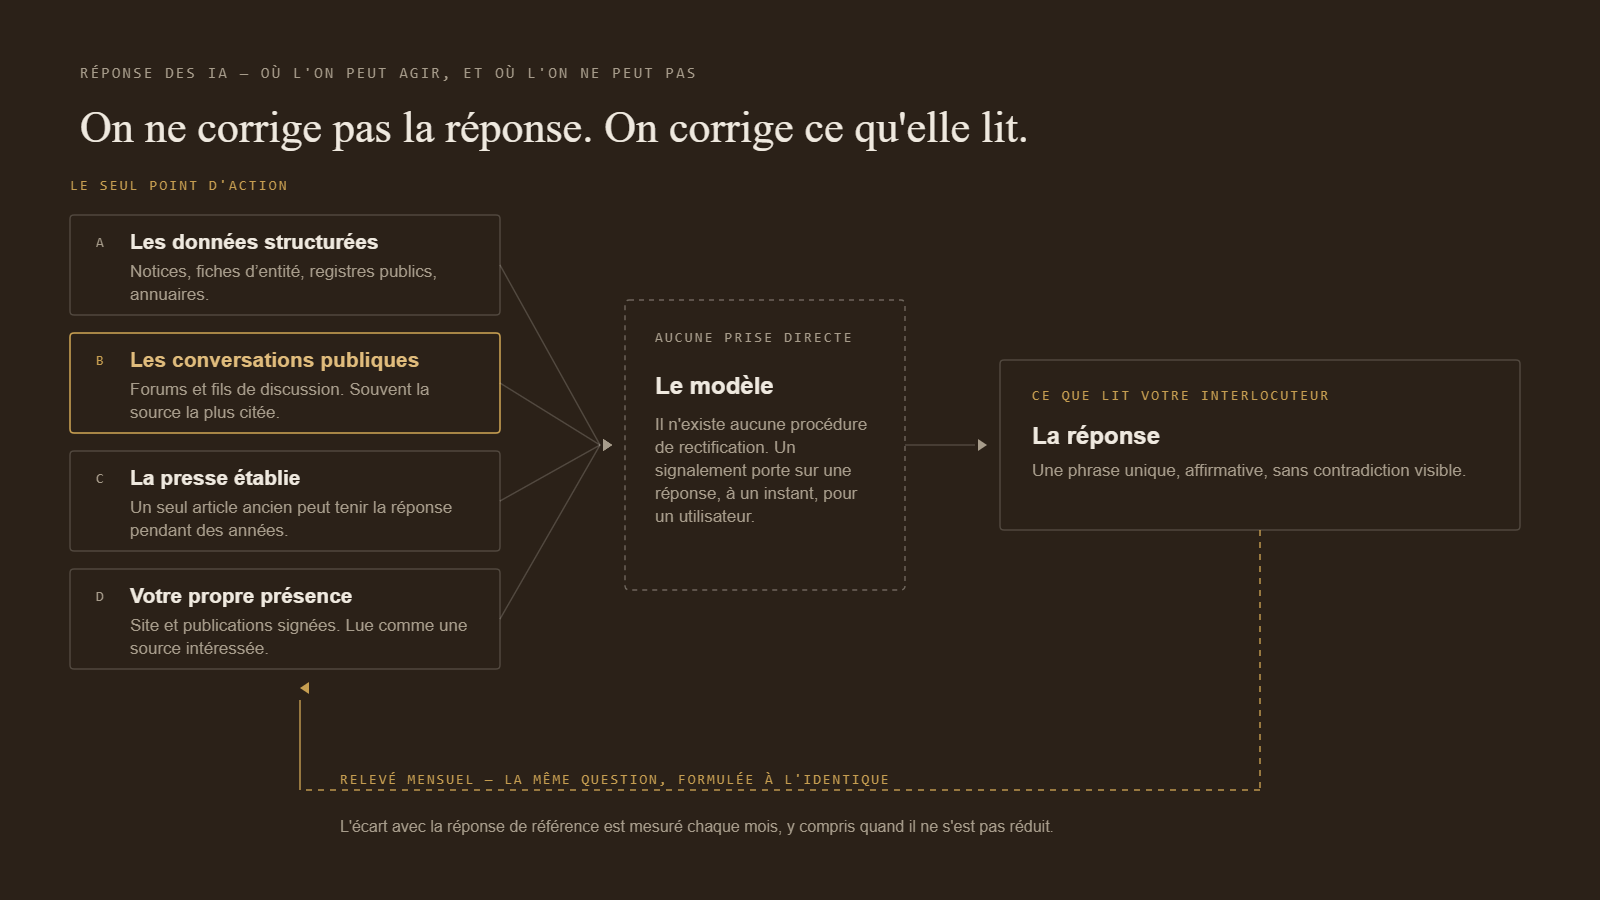
Vous pouvez signaler une réponse à un éditeur d’IA. Le signalement porte sur une réponse, à un instant, pour un utilisateur — il ne modifie ni les données d’entraînement, ni les sources que l’IA consulte au moment où elle répond à quelqu’un d’autre. Il n’existe pas d’équivalent du droit au déréférencement applicable à une IA, et les demandes fondées sur la protection des données se heurtent à un objet technique qui ne stocke pas une fiche mais des probabilités.
Le seul levier est en amont. Une IA qui affirme quelque chose de faux sur vous l’a lu quelque part, ou l’a inféré d’un ensemble de sources qui, prises ensemble, mènent à cette conclusion. On ne corrige pas l’IA : on corrige ce qu’elle lit.
C’est une compétence technique, et c’est celle qui manque aux agences de communication comme aux prestataires de référencement. La première sait produire un message, la seconde sait positionner une page. Aucune des deux ne sait établir quelle source précise produit quelle affirmation.
Les chiffres
Ce que les IA citent, mesuré plutôt que supposé
Le débat sur l’IA se tient d’ordinaire sans un chiffre. Il en existe, publics, et ils sont contre-intuitifs.
Un relevé de 680 millions de citations conduit d’août 2024 à juin 2025 donne, en part du volume total cité : chez ChatGPT, Wikipédia 7,8 %, Reddit 1,8 %, Forbes 1,1 %. Chez Perplexity, Reddit 6,6 %. Dans les aperçus IA de Google, Reddit 2,2 %, YouTube 1,9 %, Quora 1,5 %. Aucun site d’entreprise n’apparaît dans ces têtes de classement.
Deux enseignements, et le second est le plus important.
- Chaque IA a ses habitudes. Elles ne citent pas les mêmes sources, ni dans les mêmes proportions. Surveiller une seule IA ne dit rien de ce que répondent les trois autres — c’est pourquoi nous les interrogeons séparément.
- La concentration est extrême. Un travail universitaire publié en juillet 2025, portant sur 366 087 citations relevées dans 65 000 réponses, mesure que les vingt premières sources d’actualité représentent 67,3 % des citations d’OpenAI — un indice de Gini de 0,83, soit une inégalité comparable à celle des patrimoines. Chez Google 31,9 %, chez Perplexity 28,5 %.
Une réponse d’IA ne se joue donc pas sur des milliers de pages, mais sur une poignée. C’est une mauvaise nouvelle quand l’une d’elles vous dessert, et c’est une bonne nouvelle quand il s’agit d’agir : le travail est identifiable, fini, et il porte sur des objets nommés.
Le référencement ne suffit plus
Être premier sur Google ne fait plus la réponse
C’est le changement que les prestataires de référencement ne vous diront pas, parce qu’il fragilise ce qu’ils vendent.
Un relevé portant sur 863 000 pages de résultats et 4 millions d’adresses citées dans les aperçus IA de Google mesure, en mars 2026, que 37,9 % seulement des adresses citées figurent aussi dans les dix premiers résultats. En juillet 2025, c’était environ 76 %. En huit mois, la moitié du recouvrement a disparu.
Un autre analyste, sur seize mois et neuf secteurs, aboutit au même constat par un autre chemin : 16,7 % seulement des citations d’aperçus IA proviennent du top 10 organique. Et l’écart entre secteurs est considérable — 75,3 % de recouvrement en santé, 22,9 % en commerce en ligne. Un troisième relevé, sur 362 000 requêtes, trouve 44 % des citations en dehors des vingt premiers résultats.
Conclusion pratique : positionner une page reste utile, puisque les IA lisent le web. Mais une réponse se construit sur la cohérence entre plusieurs sources, pas sur le rang d’une seule. Un premier résultat contredit par trois autres ne fait pas la réponse — et une source absente de la première page peut la faire à elle seule.
La hiérarchie réelle
Quatre familles de sources, et laquelle pèse vraiment
Les données structurées
Notices encyclopédiques, fiches d’entité, registres publics, annuaires professionnels, notices d’autorité de bibliothèque. C’est le socle : une erreur qui s’y trouve est reprise partout et ne se corrige jamais seule. C’est aussi la couche par laquelle une IA sait qui vous êtes avant de dire quoi que ce soit.
Les conversations publiques
La famille la plus sous-estimée, et souvent la première citée. Forums, fils de discussion, questions-réponses. Reddit ressort en tête ou en deuxième position de presque tous les relevés, et deux accords de licence — Google en février 2024, OpenAI en mai 2024 — ont fait entrer ces contenus dans les modèles.
La presse établie
Un article de rédaction reconnue pèse davantage qu’une centaine de pages anonymes. C’est aussi pourquoi un seul papier ancien peut tenir une réponse entière pendant des années, et pourquoi la voie utile est souvent le traitement de l’article à la source.
Votre propre présence
Site, publications signées, prises de parole. La seule source que vous contrôlez entièrement — et la moins bien lue : l’IA la traite comme une source intéressée. Elle sert à établir un fait, rarement à le faire admettre seule.
Correction
Pourquoi les conversations publiques pèsent autant
Nous écrivions ici, il y a quelques mois, que les forums avaient un « faible poids unitaire ». Les relevés publiés depuis disent le contraire, et cette page se corrige.
La raison n’est pas éditoriale, elle est contractuelle. Google a signé en février 2024 une licence sur les contenus de Reddit ; OpenAI a annoncé la sienne en mai 2024, qui fait entrer Reddit dans ChatGPT. Au deuxième trimestre 2026, cette activité de licence rapporte 43 millions de dollars à Reddit, et ses deux plus gros clients sont ces deux-là. Un modèle ne « préfère » pas un forum : on lui a vendu le forum.
Du côté des données structurées, la Wikimedia Foundation écrit elle-même que « presque tous » les grands modèles s’entraînent sur des jeux de données Wikipédia, et a signé depuis janvier 2026 des accords d’accès avec Amazon, Meta, Microsoft, Mistral et Perplexity.
La conséquence pour un dirigeant est désagréable et simple : un fil de discussion vieux de six ans et une notice d’encyclopédie pèsent, dans la réponse donnée sous votre nom, plus lourd que votre site. Le détail du travail sur ces deux sources — admissibilité, fiche d’entité, règles de participation — est sur la page consacrée à la page Wikipédia et à la fiche d’entité.
L’honnêteté du chiffre
Pourquoi personne ne peut vous garantir une réponse
Le mélange de sources dont les IA se nourrissent change sans préavis, et il change vite.
Un relevé hebdomadaire de 230 000 requêtes, de juillet à octobre 2025, montre Wikipédia présent dans environ 55 % des réponses de ChatGPT au début du mois d’août 2025, puis sous les 20 % à la mi-septembre — en une semaine. Reddit passe sur la même période de près de 60 % à environ 10 %, sur ce seul outil. Au même moment, sur le mode IA de Google, Wikipédia ne pèse que 2 % et LinkedIn près de 15 %.
Personne ne contrôle cela et personne ne le prévoit. Le délai non plus ne se promet pas : nous n’avons trouvé aucune mesure sérieuse du temps qui sépare la correction d’une source de son effet sur une réponse. Notre expérience situe le décalage entre quelques semaines et quelques mois, selon l’IA et selon qu’elle consulte le web en direct ou s’appuie sur son entraînement. Quiconque vous annonce une date invente.
C’est pourquoi nous nous engageons sur le travail des sources — qui, lui, dure — et jamais sur la phrase que produira un modèle. Une garantie de présence dans les réponses d’IA porte sur l’état d’un réglage qui a changé pendant qu’on la rédigeait.
La direction du travail
Faire remonter et faire redescendre ne sont pas le même métier
Une marque qui veut être vue et un nom qui veut être oublié ne se traitent pas avec les mêmes leviers. C’est la distinction la plus utile à faire avant de choisir un prestataire.
Faire monter est un travail d’addition. On produit, on publie, on relaie, on mesure : chaque pièce ajoutée est un actif qui reste, et rien ne dépend de l’accord d’un tiers. C’est le métier des agences d’influence et de contenu, et elles le font bien.
Faire descendre est un travail de soustraction sous contrainte. Il n’existe pas d’action unilatérale : chaque retrait s’obtient d’un tiers — un éditeur, un hébergeur, un moteur, une plateforme, parfois un juge — et chacun de ces tiers exige un fondement, une qualification et une preuve. Le résultat ne dépend pas de ce que l’on produit, mais de ce que l’on démontre.
Les deux disciplines ne mobilisent donc pas les mêmes compétences. L’une est éditoriale et statistique. L’autre est juridique et technique — droit à l’oubli, RGPD, prescription, constat, déréférencement, occultation. On ne recrute pas les mêmes personnes, on ne rédige pas les mêmes pièces, et on n’annonce pas les mêmes délais.
Nous faisons les deux, dans cet ordre : d’abord ce qui doit disparaître ou reculer, ensuite ce qui doit occuper la place laissée vide. Enfouir sans retirer laisse le problème accessible ; retirer sans occuper laisse un vide que la publication suivante remplira.
Le nom du métier
Relations presse, et désormais relations algorithmiques
Il existe un métier ancien qui consiste à traiter avec ceux qui écrivent : les relations presse. Il en existe un nouveau, qui consiste à traiter avec les systèmes qui répondent. Nous l’appelons les relations algorithmiques.
Le parallèle n’est pas décoratif, il est exact. Les relations presse ne consistent pas à écrire à la place du journaliste : elles consistent à lui fournir une matière vérifiable, à connaître ses contraintes, à corriger une erreur par une pièce plutôt que par une protestation. Les relations algorithmiques procèdent de la même façon avec un moteur ou un modèle : on ne lui dicte rien, on travaille ce qu’il lit.
Concrètement : identifier les sources qu’un système cite réellement sous un nom, corriger celles qui sont fausses là où elles sont hébergées, produire celles qui manquent, rendre les données structurées cohérentes, et mesurer la réponse dans le temps plutôt que le rang d’une page.
Deux différences avec la presse, qu’il faut dire. Le destinataire n’a pas de déontologie et ne publie pas de droit de réponse : il n’y a personne à convaincre, seulement une matière à rendre juste. Et le délai n’est pas négociable — un rédacteur en chef répond dans la journée, un modèle plusieurs semaines plus tard, sans que personne puisse dire quand.
Le livrable
Le relevé de réponse de référence
C’est le document qui rend le travail vérifiable, et c’est le même que celui de l’audit d’entrée — en version mensuelle.
- Les réponses obtenues, verbatim, sur un jeu de questions fixé avec vous : qui vous êtes, ce que vous dirigez, ce qui vous est reproché, ce à quoi vous êtes associé.
- Les sources citées par chaque IA, page par page, avec ce que chacune produit dans la réponse.
- L’écart avec la réponse de référence : ce qui est faux, ce qui est périmé, ce qui manque.
- Ce qui a été fait dans le mois, et ce qui n’a pas abouti.
Le protocole compte autant que le contenu : la même question, formulée à l’identique, posée séparément à chaque IA, d’un mois sur l’autre. Une question reformulée produit une autre réponse, et une comparaison qui ne compare rien. C’est la discipline la plus ennuyeuse du dossier et c’est la seule qui rende un progrès démontrable.
Un dirigeant qui reçoit ce document tous les mois sait deux choses qu’aucun tableau de bord ne lui donne : ce qu’un investisseur lira s’il pose la question ce soir, et si la situation s’améliore.
Nous nous engageons sur des moyens, jamais sur un résultat. Nous ne sommes l’éditeur d’aucune IA, d’aucune encyclopédie, d’aucun forum, et aucun de ces acteurs n’est notre cocontractant.
Ce que nous ne faisons pas
- Aucune promesse de réponse. Nous ne nous engageons pas sur ce qu’une IA dira, parce que nous n’en sommes pas l’éditeur.
- Aucun contenu éditorial payé non signalé, aucun faux expert, aucun faux avis — y compris quand c’est le moyen le plus rapide d’occuper une source. En droit français, un faux avis expose à deux ans d’emprisonnement et 300 000 € d’amende.
- Aucune contribution encyclopédique non déclarée, aucun compte prête-nom, aucun vote coordonné sur un forum. Ce n’est pas une posture : les plateformes l’interdisent expressément et une manipulation repérée fait annuler le contenu et bannir le compte.
Ce que nous garantissons
- Le relevé avant tout engagement. Vous voyez ce que les IA répondent aujourd’hui avant de décider quoi que ce soit.
- La source de chaque affirmation. Quand une IA dit quelque chose de faux, nous vous montrons d’où ça vient.
- Un écart mesuré chaque mois, y compris quand il ne s’est pas réduit.
Questions fréquentes
Que faire si ChatGPT dit quelque chose de faux sur moi ?
Aucun formulaire ne permet de corriger une IA. Le seul levier est en amont : identifier les sources que l’IA cite réellement sous votre nom, puis les corriger ou les concurrencer. Le décalage entre la correction d’une source et le changement de la réponse se compte en semaines à quelques mois, et aucune date ne peut être promise.
Peut-on faire supprimer une réponse d’IA ?
Non, pas au sens où l’on fait retirer une page. Une réponse n’est pas un contenu stocké : elle est produite à chaque interrogation. Ce qui se supprime ou se corrige, c’est la source dont elle est tirée.
Quelles sources les IA citent-elles le plus ?
Selon les relevés publics de 2025 et 2026, un très petit nombre de domaines, dominé par les conversations publiques et l’encyclopédie : Reddit, Wikipédia, YouTube, Quora, LinkedIn. Un travail universitaire de juillet 2025 mesure que les vingt premières sources d’actualité concentrent 67,3 % des citations d’OpenAI. Aucun site d’entreprise ne figure dans ces têtes de classement.
Pourquoi Reddit compte-t-il autant ?
Parce que le contenu a été licencié. Google a signé un accord sur les contenus de Reddit en février 2024, OpenAI en mai 2024. En 2026, cette activité rapporte 43 millions de dollars par trimestre à Reddit, dont ces deux acheteurs sont les premiers. Un modèle ne préfère pas un forum : on lui a vendu le forum.
Les IA disent-elles la même chose que Google ?
De moins en moins. En mars 2026, 37,9 % seulement des adresses citées dans les aperçus IA de Google figuraient aussi dans les dix premiers résultats, contre environ 76 % en juillet 2025. Une IA qui consulte le web en direct suit à peu près l’actualité de la recherche ; une IA qui répond depuis son entraînement peut reprendre un état du web vieux de plusieurs mois.
Combien d’IA faut-il surveiller ?
Quatre suffisent à couvrir l’essentiel des usages professionnels : ChatGPT, Gemini, Perplexity et les aperçus IA de Google. Nous les interrogeons séparément, parce qu’elles ne citent ni les mêmes sources ni dans les mêmes proportions.
Est-ce du référencement ?
En partie, et c’est insuffisant. Positionner une page reste utile puisque les IA lisent le web. Mais une réponse d’IA se construit sur la cohérence entre plusieurs sources, pas sur le rang d’une seule — un premier résultat contredit par trois autres ne fait pas la réponse, et une source absente de la première page peut la faire à elle seule.
Faut-il une page Wikipédia pour être bien décrit par une IA ?
Non, et c’est une confusion coûteuse. L’article d’encyclopédie dépend d’une admissibilité que personne ne peut vendre. La fiche d’entité structurée, elle, ne demande pas de notoriété et c’est déjà ce que les moteurs et les IA lisent pour rattacher un nom à une personne réelle. Pour beaucoup de dirigeants, c’est la voie réaliste.
Combien coûte une intervention ?
Nous ne communiquons aucun montant avant d’avoir compris le périmètre. L’entretien et l’audit sont gratuits et sans engagement.
Pour aller plus loin
Ce que la réponse des IA doit à des chiffres publics
Deux notes datées rassemblent les relevés qui disent quelles sources les modèles citent réellement, et ce qu’il reste quand la voie pénale est fermée.
- Qui les IA citent vraiment, et pourquoi Reddit pèse autant. Quatre relevés indépendants, deux accords de licence, et une volatilité qui interdit toute garantie.
- Prescription de la diffamation : la réouverture après relaxe est censurée. Ce qui reste quand une IA continue de citer une accusation qu’une décision a écartée.
Le relevé de réponse des IA est signé : qui intervient sur votre dossier.
L’audit est offert
Trente à quarante-cinq minutes pour qualifier l’objet du problème, puis un relevé écrit : ce que quatre IA répondent aujourd’hui sous votre nom, les sources qu’elles citent, et ce qui produit chaque affirmation. Gratuit, confidentiel, sans engagement.
01 85 09 08 00
24 h/24 — si votre situation est en cours, appelez
